
Zuletzt aktualisiert am: 12. November 2026
Wie gut ist ein Coding-Agent wirklich, und zwar auf dem eigenen Code statt auf einer Rangliste? Diese Frage beantwortet ein Benchmark für Coding-Agenten, der direkt aus der Git-Historie eines Projekts entsteht.
Im ersten Teil dieser Serie haben wir gezeigt, warum der Harness die eigentliche Stellschraube ist. Gemeint sind die Skills, Regeln, Tools und das Projektwissen, mit denen ein Team seinen Agenten ausstattet, denn Agent ist gleich Harness plus Modell. Bei mgm haben wir dafür unter dem Namen ESACA (European Sovereign Agentic Coding Appliance) einen Kreislauf entwickelt: Teams führen ihre Harnesses in einer sicheren Sandbox aus und teilen sie über eine Registry. Die Nutzung zeigt, welche sich durchsetzen. [LINK: Teil 1 der Serie]
Beliebt heißt aber noch nicht gut. In diesem zweiten Teil geht es um die beiden Schritte, die aus beliebt verifiziert machen: messen und verbessern.
Messen: Nur, was sich durchgesetzt hat
Jede Variante jedes Harness mit jedem Modell zu benchmarken, wäre unbezahlbar. Testfälle mal Modelle mal Wiederholungen kosten schnell viel Rechenzeit. Die Emergenz aus der Registry entschärft dieses Problem. Wir messen gezielt die Harnesses, auf die sich viele Teams zubewegt haben. Dort lohnt sich jede gefundene Verbesserung am meisten, weil sie vielen Projekten zugutekommt.
Warum öffentliche Benchmarks für Coding-Agenten nicht reichen
Benchmarks für Coding-Modelle gibt es viele, etwa SWE-bench, LiveCodeBench oder Aider Polyglot. Warum also ein eigener? Weil die öffentlichen Ranglisten eine andere Frage beantworten:
- Fremder Harness. Gemessen wird mit einem Standard-Gerüst. Die eigenen Skills und Regeln, also genau das, was den Unterschied macht, fehlen.
- Andere Aufgaben, andere Sprachen. Viele Benchmarks setzen stark auf Python und einzelne Funktionen. Unternehmenscode ist ein System mit Abhängigkeiten, oft in Java oder mit eigenen Modellierungssprachen, die in keinem Trainingsdatensatz stehen.
- Bekannte Testaufgaben können längst in den Trainingsdaten stecken.
- Andere Infrastruktur. Laufzeiten beim Hyperscaler sagen wenig über die eigene Hardware.
- Nicht übertragbar. Den eigenen Code und die eigenen Tickets kann und darf niemand veröffentlichen.
Bei uns kommt eine besondere Herausforderung hinzu. Viele unserer Projekte arbeiten nicht nur mit Java oder Python, sondern mit den Modellen der A12 AI Low Code Plattform. Wie gut ein Agent damit umgeht, kann keine öffentliche Rangliste zeigen. Ein Ranglistenplatz ist also ein Indiz, aber keine Entscheidungsgrundlage für das eigene Projekt.
Die Git-Historie ist der Testdatensatz
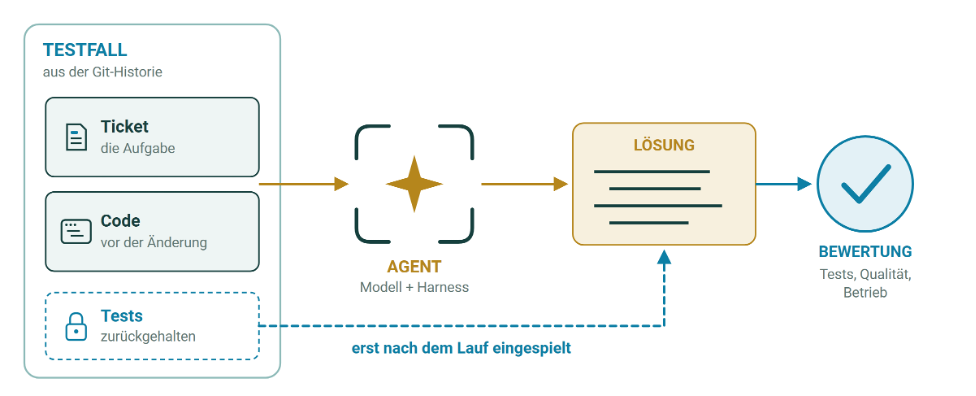
Der Kern der Methode ist eine einfache Beobachtung: Ein Repository enthält bereits Aufgaben und ihre Lösungen. Ein Commit mit Ticket-Referenz und passenden Tests ist im Grunde ein fertiger Testfall. Die Aufgabe steht im Ticket, die Lösung im Code, und die Tests prüfen, ob sie funktioniert.
Ein Werkzeug durchsucht die Historie nach Ticket-Referenzen und Teständerungen und fasst zusammengehörige Commits zusammen, denn Tests landen oft nicht im selben Commit wie der Code. Es prüft, ob der Code baut und ob das Ticket aussagekräftig genug ist. Ein Sprachmodell schätzt Schwierigkeit und Kategorie, etwa Bugfix oder Feature, Frontend oder Backend. Zum Schluss kuratiert ein Mensch. Aus dem Repository unseres eigenen ESACA-Projekts entstanden so echte Testfälle, weitgehend automatisch.
Im Benchmark bekommt der Agent nur das Ticket und den Code vor der Änderung. Die Tests aus dem Repository spielen wir erst nach seinem Lauf ein. So kann sich der Agent nicht an ihnen orientieren, und sie bleiben ein ehrlicher Prüfstein.
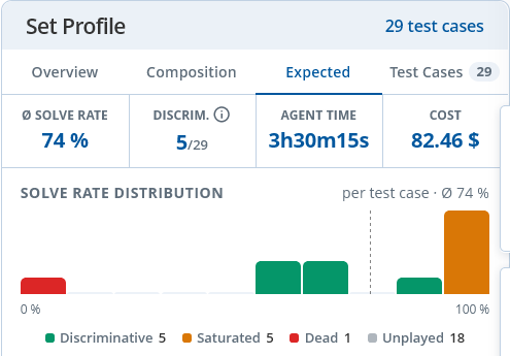
Die so gewonnenen Testfälle sind keine Musterlösungen. Sie zeigen, wie im Unternehmen tatsächlich gearbeitet wird, und genau das macht sie aussagekräftig. Über die Metadaten lassen sich Testsets nach der jeweiligen Frage zusammenstellen: Wie gut ist ein Harness im Frontend, im Java-Backend oder mit den A12-Modellen? Auch Testfälle ohne Aussagekraft fallen auf, etwa solche, die jedes Modell löst, oder solche, die keines schafft.
Fair bewerten: drei Dimensionen
Ob die Tests grün sind, ist nur ein Teil der Wahrheit. Deshalb bewerten wir jeden Lauf in drei Dimensionen, mit insgesamt 23 Einzelwerten:
- Aufgabenerfüllung: Baut der Code? Laufen die Tests durch?
- Codequalität: Komplexität, Duplikate, Umfang der Änderung, Sicherheit und mehr. Das meiste messen wir algorithmisch. Schwer Messbares wie Dokumentation oder Sicherheit beurteilt ein Sprachmodell als Gutachter, und zwar nie das Modell, das gerade getestet wird. Modelle bewerten ihren eigenen Code sonst zu gut.
- Betrieb: Kosten, Laufzeit, Arbeitsschritte, Tokens.
Warum diese Trennung? Löst ein Agent einen Bug mit drei Zeilen, ist das besser, als wenn er dafür fünf neue Klassen mit 3.000 Zeilen schreibt, auch wenn in beiden Fällen alle Tests grün sind. Jeder Lauf startet in einer frischen Sandbox und lässt sich wiederholen, denn Sprachmodelle antworten nicht deterministisch.
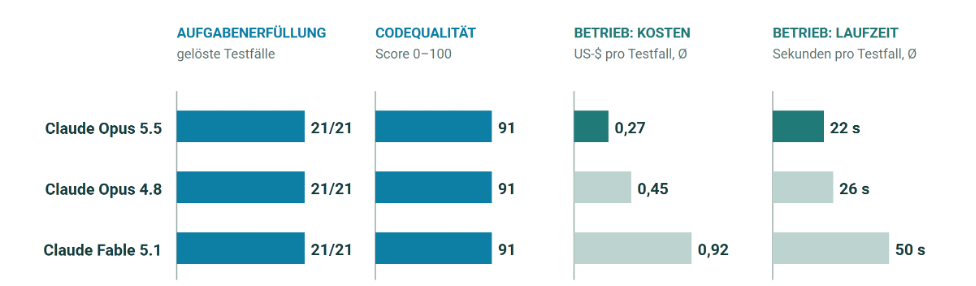
Ein Beispiel aus unserer Demo: Drei Modelle bearbeiteten dieselben 21 Testfälle aus unserem ESACA-Repository. Alle drei lösten jede Aufgabe, und auch bei der Codequalität lagen sie gleichauf. Den Unterschied zeigte erst der Betrieb. Das schnellste Modell brauchte im Schnitt 22 Sekunden und 0,27 US-Dollar pro Testfall, das langsamste 50 Sekunden und 0,92 US-Dollar. Gleich gut heißt nicht gleich teuer. Die Demo lief mit Cloud-Modellen, das Verfahren funktioniert aber genauso für Modelle im eigenen Rechenzentrum. Und es funktioniert ebenso in die andere Richtung: gleiches Modell, gleiches Testset, verschiedene Harnesses.
[BILD: Drei Modelle auf demselben Testset: gleiche Erfolgsquote und Qualität, deutliche Unterschiede bei Kosten und Laufzeit (Demo mit 21 Testfällen); Querformat; Quelle: bilder-v3/13_modellvergleich-drei-dimensionen.png]
Verbessern: Aus beliebt wird verifiziert
Was sich reproduzierbar messen lässt, lässt sich auch verbessern. Die Optimierungsschleife setzt direkt am Harness an. Zuerst misst sie die Ausgangslage. Dann liest ein Hilfsmodell die Protokolle der gescheiterten Läufe und schlägt genau eine gezielte Änderung am Skill vor. Danach misst die Schleife erneut. Nur bestätigte Verbesserungen bleiben, alles andere rollt sie zurück.
Bevor wir ein Ergebnis übernehmen, prüfen wir es auf zurückgehaltenen Testfällen, damit der Skill nicht nur auf die Übungsaufgaben passt. Am Ende entscheidet ein Mensch, ob es ins Team zurückfließt. Optimieren lässt sich auf Kosten, Laufzeit oder Codequalität, zum Beispiel nachts, wenn die Rechenkapazität ohnehin frei ist.
[BILD: Optimierungsschleife: messen, Fehlschläge analysieren, genau eine Änderung, erneut messen, nur Verbesserungen behalten, am Ende Prüfung auf zurückgehaltenen Testfällen und menschliches Review; Querformat; Quelle: bilder-v3/14_optimierungsschleife.png]
Unsere Experimente zeigen: Das funktioniert nicht immer. Ob die Schleife konvergiert, hängt stark vom optimierenden Modell ab, und ein bereits ausgereifter Skill wird nicht plötzlich halb so teuer. Der vielleicht größte Gewinn liegt woanders: Man weiß endlich, ob ein Skill überhaupt etwas bringt. Skills altern außerdem. Ein Skill, der ein älteres Modell auf ein bestimmtes Niveau gehoben hat, kann ein stärkeres neues Modell einengen. Ohne Messung merkt das niemand.
Damit schließt sich der Kreis. Der verbesserte Harness geht als geprüfte Version zurück in die Registry, zusammen mit seinen Messwerten. Das Team in Leipzig übernimmt dann nicht nur das Setup aus Aachen, sondern weiß auch, dass es nachweislich besser ist. Und weil verifizierte Harnesses ihrerseits häufiger übernommen werden, verstärkt sich der Kreislauf selbst.
Wo der Ansatz an Grenzen stößt
Emergenz braucht Masse. Damit sich aus der Nutzung ablesen lässt, was sich bewährt, müssen genug Teams mitmachen und ihre Harnesses tatsächlich teilen. Auch die Datenbasis muss stimmen: Das Repository braucht genug Commits mit Tests und aussagekräftigen Tickets.
Im Benchmark bekommt der Agent ein Ticket und arbeitet allein. Echte Entwickler arbeiten iterativ und stellen Rückfragen. Diese Interaktion zu simulieren, ist unser nächster Schritt. Websuche und externe Dienste schließen wir im Benchmark bewusst aus, damit die Messung vergleichbar bleibt. Dadurch fehlt allerdings ein Teil der Entwicklerrealität.
Und schließlich der Aufwand: Auch mit gezielter Auswahl kosten Messung und Optimierung Rechenzeit. Für ein kleines Team lohnt sich das kaum. In einem großen Unternehmen, in dem ein Harness viele Projekte trägt, zahlt sich jede gefundene Verbesserung dagegen vielfach aus.
Fünf Prinzipien zum Mitnehmen
- Behandeln Sie den Harness als eigene Stellschraube. Gleiches Modell, anderer Harness, anderes Ergebnis.
- Machen Sie die sichere Umgebung zur bequemsten. Sonst entsteht Schatten-IT.
- Lassen Sie Standards entstehen, statt sie zu verordnen. Die Nutzung zeigt, welche Harnesses sich bewähren, und genau die lohnt es sich zu messen.
- Messen Sie auf Ihrem Code, nicht auf der Rangliste. Ihre Git-Historie ist Ihr Testdatensatz.
- Teilen Sie, was nachweislich funktioniert, und messen Sie wieder.
Fazit und Ausblick
Coding-Agenten werden im Unternehmen nicht dadurch besser, dass jedes Team für sich weiter experimentiert, und auch nicht dadurch, dass jemand zentral einen Standard festlegt. Sie werden besser, wenn Teams frei ausprobieren, das Erfolgreiche teilen und das Geteilte auf dem eigenen Code nachweisen. Der Harness ist dabei die Stellschraube, die ein Unternehmen selbst in der Hand hat.
Bei mgm entwickeln wir diesen Kreislauf unter dem Namen ESACA, gemeinsam mit Partnern wie Fsas Technologies, einem Unternehmen von Fujitsu. Ziel ist, KI-gestützte Softwareentwicklung auch dort möglich zu machen, wo Code und Daten das eigene Rechenzentrum nicht verlassen dürfen. Spannende Fragen liegen noch vor uns: Wie simuliert man Rückfragen im Benchmark realistisch? Wie bezieht man externe Dienste ein, ohne die Messung zu verfälschen? Und woran erkennt man früh, welcher Harness sich durchsetzen wird?
Sie interessieren sich für souveränes, agentisches Coding?
Häufig gestellte Fragen (FAQ)
Warum reichen öffentliche Benchmarks für Coding-Agenten nicht aus?
Sie messen mit einem Standard-Harness, oft auf Python-Aufgaben, auf fremder Infrastruktur und mit Aufgaben, die bereits in Trainingsdaten stecken können. Über die Leistung im eigenen Projekt mit eigenen Skills und Regeln sagen sie deshalb wenig.
Wie entsteht ein Benchmark aus der Git-Historie?
Commits mit Ticket-Referenz und passenden Tests werden zu Testfällen. Der Agent erhält nur das Ticket und den Code vor der Änderung, die Tests aus dem Repository prüfen sein Ergebnis erst nach dem Lauf.
Nach welchen Kriterien wird ein Coding-Agent bewertet?
In drei Dimensionen mit insgesamt 23 Einzelwerten: Aufgabenerfüllung, Codequalität und Betrieb, also Kosten, Laufzeit, Arbeitsschritte und Tokens.
Lassen sich Skills automatisch verbessern?
Ja, in vielen Fällen. Eine Optimierungsschleife schlägt auf Basis gescheiterter Läufe jeweils eine gezielte Änderung vor und behält nur messbare Verbesserungen. Ob sie konvergiert, hängt stark vom optimierenden Modell ab.
Funktioniert das auch mit Modellen im eigenen Rechenzentrum?
Ja. Das Verfahren ist unabhängig davon, wo das Modell läuft, und eignet sich gerade für Open-Weight-Modelle, die Unternehmen und Behörden selbst betreiben.