
Zuletzt aktualisiert am: 11. November 2026
Coding-Agenten sind in vielen Entwicklungsteams angekommen, auch bei uns. Ob sie im Alltag wirklich helfen, hängt aber oft weniger vom Sprachmodell ab als vom Harness für Coding-Agenten: den Skills, Regeln, Tools und dem Projektwissen, mit denen ein Team seinen Agenten ausstattet. Meist baut jedes Team seinen eigenen, und ob er wirklich etwas bringt, weiß niemand genau.
Bei mgm haben wir deshalb eine Methode entwickelt, die daraus einen lernenden Kreislauf macht: Harnesses sicher ausführen und teilen, die erfolgreichsten auf dem eigenen Code messen und verbessern und das Ergebnis wieder allen Teams zur Verfügung stellen. Entstanden ist sie aus unserem eigenen Alltag. Viele Unternehmen stehen aber vor genau denselben Fragen. In diesem ersten Teil geht es um das Ausführen und Teilen. Der zweite Teil widmet sich dem Messen und Verbessern.

Jedes Team baut seinen eigenen Harness
mgm arbeitet an vielen Standorten in zahlreichen Projekten. In Aachen hat ein Team herausgefunden, mit welchen Skills und Regeln sein Coding-Agent im Projekt verlässlich gute Ergebnisse liefert. Ein Team in Leipzig arbeitet an einem sehr ähnlichen Projekt und fängt bei null an. Best-Practice-Runden gibt es. Die KI-Welt dreht sich aber schneller, als sich Erfahrungen auf dem Flur herumsprechen.
Dazu kommen zwei unbequeme Fragen. Erstens: Was davon funktioniert eigentlich wirklich? Ob ein Skill hilft oder nur Tokens kostet, entscheidet heute meist das Bauchgefühl. Zweitens: Wo laufen die Agenten, und was sehen sie? Wer Entwicklerinnen und Entwicklern kein sicheres Angebot macht, bekommt Schatten-IT, etwa den privaten Chat-Account, der „nur kurz“ ein Coding-Problem löst.
Unsere These: KI in der Softwareentwicklung ist keine einmalige Tool-Einführung. Sie ist ein Kreislauf, den man wie jedes andere Engineering-Problem messen und verbessern kann. Im Zentrum dieses Kreislaufs steht nicht das Modell, sondern der Harness.
Warum der Harness für Coding-Agenten die Stellschraube ist
Die öffentliche Diskussion dreht sich meist um Modelle: Welches ist gerade das beste? In der Praxis arbeitet aber kein Modell allein. Es steckt in einem Harness. Dazu gehören die Agenten-App (etwa Claude Code oder OpenCode), die Skills, die Tools, die Regeln und das Projektwissen. Hinzu kommen MCP-Server, über die der Agent nach dem Model Context Protocol externe Tools und Datenquellen anbindet. Erst Harness und Modell zusammen ergeben den Agenten, mit dem ein Entwickler arbeitet.

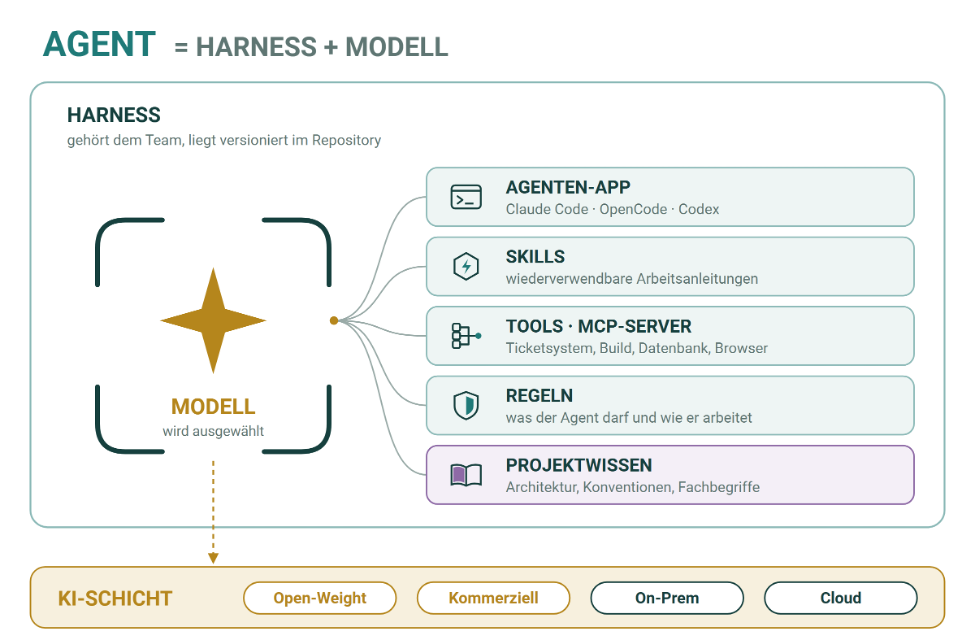
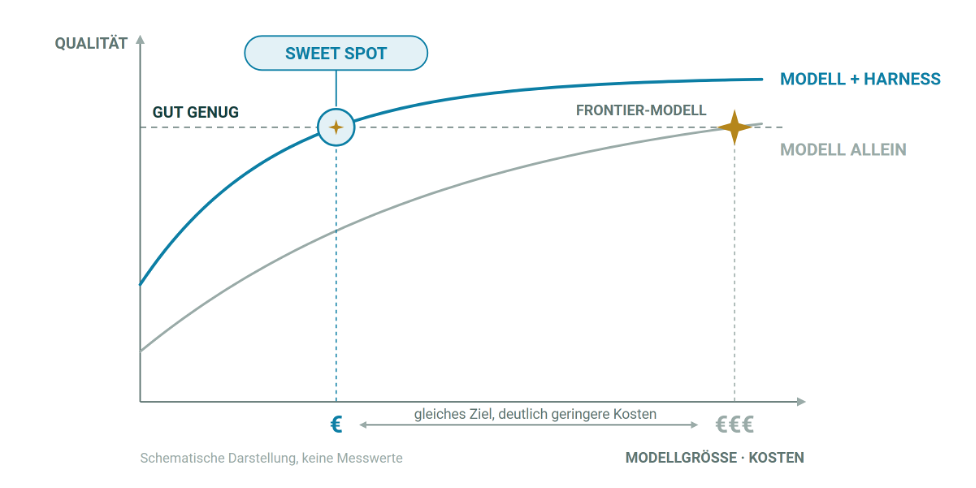
Das hat Folgen: Gleiches Modell, anderer Harness, anderes Ergebnis. Besonders deutlich wird das bei kleineren Open-Weight-Modellen, deren Gewichte frei verfügbar sind und die sich deshalb selbst betreiben lassen. Viele Unternehmen und Behörden brauchen genau das, weil Code und Daten das eigene Rechenzentrum nicht verlassen dürfen. Ein großes Frontier-Modell, also eines der leistungsstärksten aktuellen Modelle, verzeiht vieles. Ein kleines Modell braucht deutlich mehr Führung. Mit dem passenden Harness rückt es für viele Aufgaben aber nah an die großen Modelle heran, zu einem Bruchteil der Kosten.

Der Harness hat noch eine zweite Eigenschaft, die ihn vom Modell unterscheidet: Er gehört dem Team. Er besteht aus Dateien, lässt sich versionieren, im Repository ablegen, weitergeben und gezielt verändern. Damit ist er genau die Stelle, an der sich ein Unternehmen verbessern kann, ohne auf das nächste Modell zu warten.
Die eigentliche Frage lautet deshalb nicht „Welches ist das beste Modell?“, sondern: Welcher Harness löst mit welchem Modell unsere Aufgaben auf unserer Infrastruktur am besten? Und wie findet man ihn, ohne jede denkbare Kombination durchzuprobieren?
Der Kreislauf im Überblick
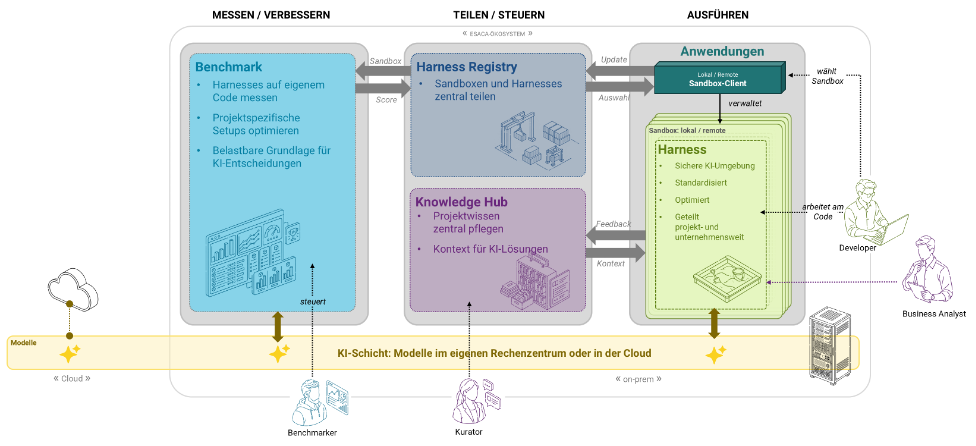
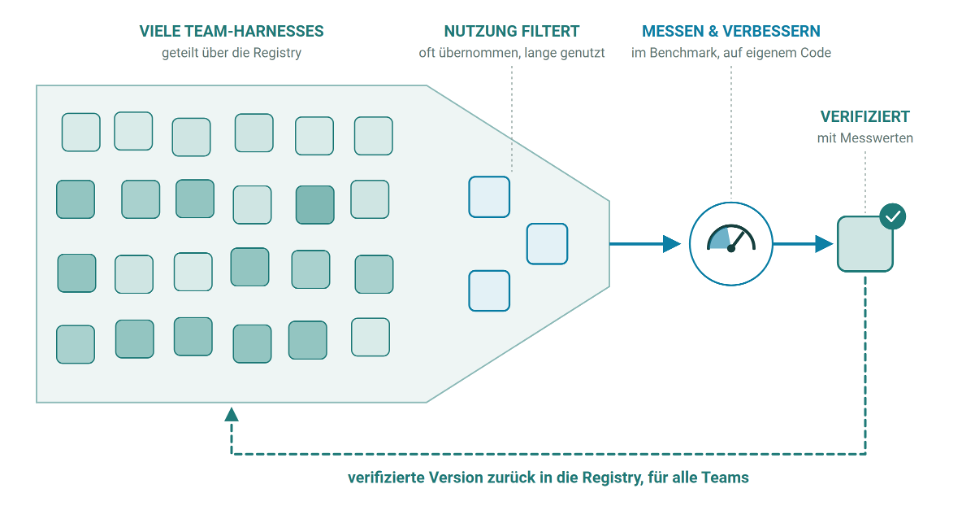
Unsere Antwort ist ein Kreislauf mit eingebautem Filter. Viele Harnesses entstehen und werden geteilt, aber nur die, die sich in der Praxis durchsetzen, messen und verbessern wir mit größerem Aufwand. Bei mgm entwickeln wir diesen Kreislauf unter dem Namen ESACA (European Sovereign Agentic Coding Appliance). Alle vier Schritte laufen auf derselben KI-Schicht, im eigenen Rechenzentrum oder in der Cloud.

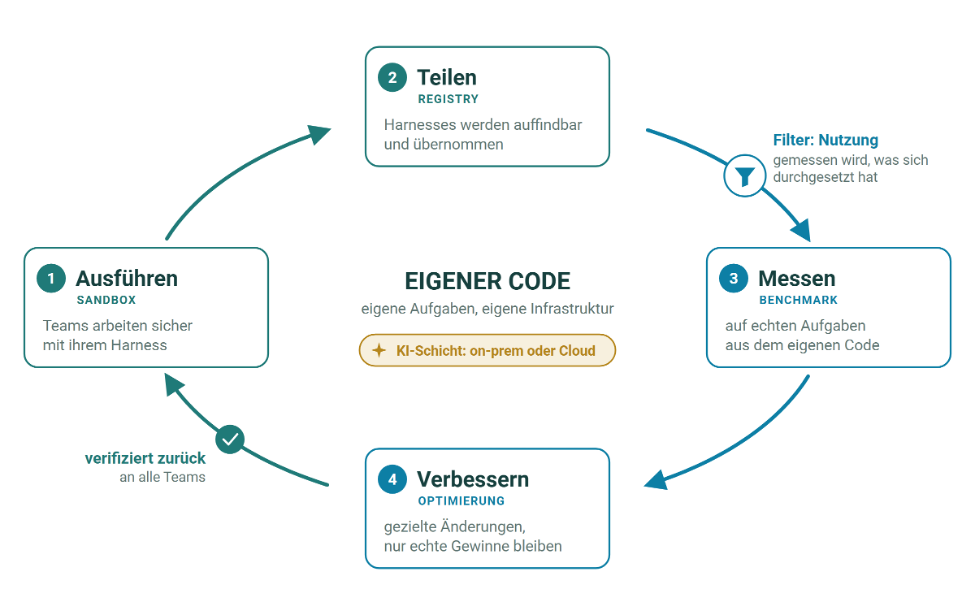
- Ausführen: die Sandbox. Teams arbeiten mit ihrem Harness in einer sicheren, vorkonfigurierten Umgebung. Die Konfiguration liegt im Repository und lässt sich teilen.
- Teilen: die Registry. Teams veröffentlichen ihre Harnesses zentral und übernehmen sie in jede andere Sandbox. So zeigt sich, welche Setups sich in der Praxis durchsetzen.
- Messen: der Benchmark. Die Harnesses, die sich durchgesetzt haben, testen wir automatisiert gegen echte Aufgaben aus den eigenen Projekten.
- Verbessern: die Optimierung. Was gemessen ist, lässt sich gezielt verbessern. Die geprüfte Version geht zurück in die Registry.
Das Prinzip: Teams experimentieren frei, die Nutzung zeigt, was sich bewährt, und nur das wird gemessen und verbessert. Einmal optimiert, überall genutzt. Danach beginnt die Runde von vorn, denn neue Modelle, neue Skills und neue Projekte verschieben das Bild ständig. Die ersten beiden Schritte schauen wir uns jetzt genauer an.
Ausführen: Eine Sandbox, die nicht im Weg steht
Wer Entwicklern einen Agenten gibt, muss eine Sandbox mitdenken. Drei Risiken stehen im Vordergrund. Zugangsdaten können über Skills oder MCP-Server nach außen gelangen. Der Agent hat dieselben Rechte wie der Entwickler, auf lokale wie auf verbundene Systeme. Und interne Daten können abfließen.
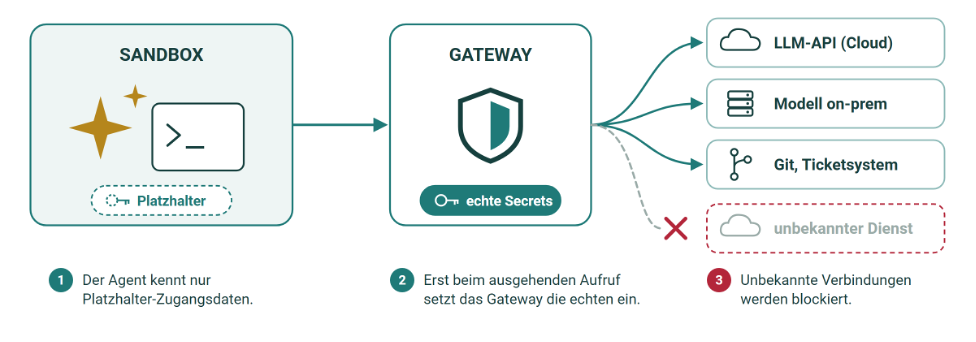
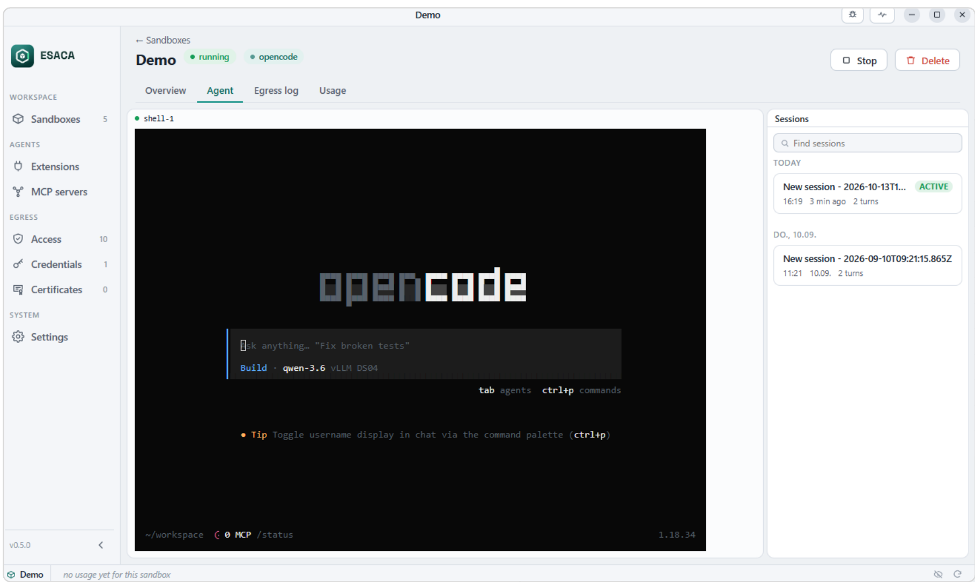
Unser Ansatz ist eine isolierte Umgebung mit vorgeschaltetem Gateway. Die Sandbox kennt nur Platzhalter. Die echten Zugangsdaten liegen im Gateway und kommen erst beim ausgehenden Aufruf dazu. Verbindungen zu unbekannten Zielen blockiert das Gateway von vornherein.

Mindestens so wichtig wie die Sicherheit ist die Bequemlichkeit. Eine umständliche Sandbox wird umgangen, denn der ungeschützte Agent in der Konsole ist nur einen Befehl entfernt. Deshalb gilt: einmal einrichten, den Harness samt Sandbox-Konfiguration im Repository ablegen, und jede Kollegin und jeder Kollege startet mit derselben Umgebung, inklusive Skills und MCP-Servern und mit den gängigen IDEs.
Damit verschiebt sich auch der Blick. Statt jeden Entwickler einzeln zu optimieren, optimieren wir das Team. Jedes Projekt bekommt einen gemeinsamen Basis-Harness, auf den jeder eigene Skills legen kann. Das ist der erste geteilte Harness, und genau er lässt sich später messen.

Teilen: Viele Harnesses, wenige setzen sich durch
Liegt der Harness erst einmal als Konfiguration im Repository, lässt er sich auch über das eigene Projekt hinaus teilen. Eine Registry macht Sandbox-Konfigurationen samt Skills, Regeln und MCP-Servern für alle Teams auffindbar. Die Bausteine sind einzeln versioniert und lassen sich zu Paketen bündeln, ähnlich wie man es vom JavaScript-Paketmanager npm kennt. Das Team in Leipzig muss also nicht bei null anfangen. Es holt sich den Harness aus Aachen und passt ihn an sein Projekt an.
So entsteht schnell eine Vielfalt, und das ist gewollt. Man könnte versuchen, zentral einen Standard-Harness festzulegen. Doch wer weit weg vom Projekt ist, weiß selten, was im Alltag eines Teams wirklich hilft. Wir setzen deshalb auf Emergenz: Teams probieren frei aus, übernehmen voneinander und passen an. Welche Harnesses oft übernommen und lange beibehalten werden, zeigt die Nutzung. Ähnlich setzen sich im Open-Source-Ökosystem einzelne Bibliotheken durch, ohne dass sie jemand verordnet hätte.

Ergänzend entsteht ein Knowledge Hub, der Richtlinien und Projektwissen in abgestuften Bereichen sammelt: vom ganzen Unternehmen über Team und Projekt bis zum Einzelnen. Auch dieses Wissen ist Teil des Harness. Davon profitieren gerade kleinere Modelle, die mehr Kontext brauchen.
Nutzung allein beweist aber noch keine Qualität. Ein Harness kann beliebt sein, weil er früh da war, weil ein bekanntes Team ihn verwendet oder weil er sich gut anfühlt. Ob er tatsächlich bessere Ergebnisse liefert, beantwortet erst die Messung. Die Emergenz sagt uns, wo wir messen sollten. Der Benchmark sagt uns, ob sich das Beliebte auch bewährt.
Zwischenfazit und Ausblick auf Teil 2
Eine bequeme, sichere Sandbox und eine Registry für geteilte Harnesses schaffen die Grundlage: Teams arbeiten geschützt, profitieren voneinander, und es wird sichtbar, welche Setups sich durchsetzen. Im zweiten Teil zeige ich, wie wir diese Kandidaten auf echten Aufgaben aus der eigenen Git-Historie messen und automatisiert verbessern. Und ich spreche offen darüber, wo der Ansatz heute noch an Grenzen stößt. [LINK: Teil 2 der Serie, sobald veröffentlicht]
Sie interessieren sich für souveränes, agentisches Coding?
Häufige gestellte Fragen (FAQ)
Was ist ein Harness bei Coding-Agenten?
Ein Sprachmodell allein verarbeitet Eingaben und erzeugt Ausgaben, kann jedoch nicht eigenständig mit seiner Umgebung interagieren. Erst der Harness bettet das Modell in einen gesteuerten Arbeitsablauf ein, der die Interaktion mit Werkzeugen und externen Systemen ermöglicht. Der Harness umfasst die dafür notwendige Steuerungs- und Integrationsschicht: die Agenten-App, die Verwaltung von Kontext und Projektwissen sowie die Einbindung von Skills, Tools und MCP-Servern. Er koordiniert die Ausführung von Aktionen und setzt Regeln und Berechtigungen durch. Erst Harness und Modell zusammen ergeben den Coding-Agenten, mit dem Entwicklerinnen und Entwickler arbeiten.
Warum ist der Harness so wichtig wie das Modell?
Mit demselben Modell liefert ein anderer Harness andere Ergebnisse. Gerade kleinere Open-Weight-Modelle im eigenen Rechenzentrum erreichen mit einem passenden Harness für viele Aufgaben ein gutes Niveau, deutlich günstiger als große Frontier-Modelle.
Wie schützt eine Sandbox vor dem Abfluss von Zugangsdaten?
In unserem Ansatz kennt die Sandbox nur Platzhalter. Die echten Zugangsdaten setzt ein vorgeschaltetes Gateway erst beim ausgehenden Aufruf ein, und Verbindungen zu unbekannten Zielen blockiert es von vornherein.
Was leistet eine Harness Registry?
Sie macht Sandbox-Konfigurationen mit Skills, Regeln und MCP-Servern für alle Teams auffindbar und versioniert. Teams übernehmen bewährte Harnesses voneinander, und die Nutzung zeigt, welche sich in der Praxis durchsetzen.